وقتی سیستم اصلی سازمان در شلوغترین ساعت کاری از کار میافتد، معمولاً دلیلش یک اشتباه بزرگ نیست، بلکه انباشت چند مشکل کوچک است: تنظیمات ناخواستهی تغییرکرده، شبکهی بد تفکیکشده و پشتیبانگیریای که در عمل جواب نمیدهد. خرید سرور یا پهنای باند بیشتر فقط مشکل را موقتاً پنهان میکند. در این مطلب، مسیر تقویت زیرساخت را در چهار بخش بررسی میکنیم: امنیت کد و تنظیمات، معماری «اعتماد صفر»، بازیابی پس از فاجعه و پایش هوشمند.
سرعت یا پایداری؟ توازن درست در توسعه زیرساخت IT
توسعه زیرساخت فناوری اطلاعات همیشه بین دو خواسته متضاد گیر میکند: تیمهای نرمافزاری دنبال انتشار سریعتر تغییراتاند، تیمهای عملیاتی دنبال ثبات. این تعارض وقتی بحرانی میشود که با زیرساخت مثل یک بلوک یکپارچه رفتار کنیم؛ درحالیکه در واقعیت، هفت لایه بههموابسته داریم: سختافزار، سیستمعامل، شبکه، پایگاه داده، کلود/مجازیسازی، امنیت و دیتاسنتر. اختلال در هر لایه، به دلیل وابستگی متقابل، میتواند کل زنجیره سرویس را متوقف کند.
مشکل دیگر، اتکا به دفاع پیرامونی (Perimeter Security) است؛ مدلی که فرض میکند مرز مشخصی بین «داخل امن» و «بیرون ناامن» وجود دارد. با پخش شدن بارهای کاری بین آنپرمیس و چند کلود، این مرز عملاً محو شده و فایروال لبه شبکه دیگر نقطه کنترل کافی نیست.
راهحل، بازطراحی معماری بر اساس چارچوبهای تابآوری تثبیتشده است. چارچوب NIST SP 800-160 Vol. 2 چهار پتانسیل مهم را برای سیستمهای تابآور تعریف میکند:


-
پیشبینی: شناسایی نقاط آسیبپذیر پیش از بهرهبرداری
-
مقاومت: حفظ عملکرد حداقلی حین حمله یا خرابی جزئی
-
بازیابی: بازگشت سریع به وضعیت پایدار
-
تطبیقپذیری: اصلاح معماری بر اساس الگوهای تهدید جدید
این چهار توانایی فقط مفاهیم نظری نیستند؛ در ادامه میبینیم چطور هرکدام به تصمیمات فنی مشخص در لایه IaC، شبکه و بکاپ ترجمه میشوند.
امنیت لایه کد؛ از IaC تا Policy as Code
مدیریت دستی زیرساخت، منبع اصلی انحراف پیکربندی است. وقتی تنظیمات سرورها و شبکه از طریق پنلها یا اسکریپتهای موردی اعمال میشوند، هیچ تضمینی نیست که وضعیت واقعی سیستم با آنچه در ذهن تیم است یکسان بماند. رویکرد زیرساخت بهعنوان کد (IaC) این مشکل را با تعریف declarative کلسترها، شبکه و مخازن داده حل میکند؛ اما خودش هم یک ریسک جدید میسازد: یک خطای کوچک در کد Terraform میتواند در چند ثانیه روی صدها سرور تکرار شود.
راهحل، انتقال امنیت به مراحل ابتدایی خطلوله یکپارچهسازی و استقرار پیوسته (CI/CD) است، یعنی بررسی کد پیش از اجرا، نه بعد از بروز حادثه. این کار در عمل سه لایه کنترل نیاز دارد:
-
اسکن ایستای کد (SAST): ابزارهایی مثل Checkov و TFSec، کد Terraform یا CloudFormation را قبل از deploy آنالیز میکنند و مواردی مثل پورتهای باز یا دسترسی عمومی ناخواسته را شناسایی میکنند.
-
سیاست بهعنوان کد: Open Policy Agent (OPA) قوانینی مثل «S3 Bucket نباید عمومی باشد» را بهصورت خودکار در pipeline اعمال میکند، نه بهصورت چکلیست دستی.
-
مدیریت کلیدها: ابزارهایی مثل HashiCorp Vault، کلیدها و پسوردهای هاردکدشده در کد را حذف میکنند یکی از رایجترین نقاط ورود مهاجمان.
جریان کار در چنین خطلولهای معمولاً اینطور است: توسعهدهنده کد را ثبت میکند، اسکنر آن را بررسی میکند، سیاستهای تعریفشده اعمال میشوند، Vault کلیدهای لازم را تزریق میکند، و تنها در صورت عبور از همه این مراحل، استقرار روی پروداکشن انجام میشود.
نکتهای که این معماری را قابلاتکا میکند، تکرارپذیری است: اجرای چندبارهی همان کد IaC، باید دقیقاً همان وضعیت مطلوب را بازتولید کند، نه تغییرات ناخواستهی جدید. این ویژگی، دقیقاً همان چیزی است که انحراف پیکربندی را از ریشه از بین میبرد، نه با نظارت مداوم انسانی، بلکه با حذف امکان بروز آن.
اعتماد صفر در دیتاسنتر
فایروال لبه شبکه، فرض میکند خطر فقط از بیرون میآید. اما اگر مهاجم از همین لبه عبور کند، در محیطهای سنتی میتواند آزادانه در شبکه داخلی حرکت کند. پدیدهای که به آن حرکت جانبی گفته میشود. معماری اعتماد صفر (Zero Trust) دقیقاً برای بستن همین حفره طراحی شده: اصل بنیادیاش این است که «هیچگاه اعتماد نکن، همیشه احراز هویت کن»، حتی برای کاربر یا سرویسی که از قبل داخل شبکه است.
پیادهسازی این اصل در سطح دیتاسنتر، سه رکن اصلی دارد:
-
Microsegmentation: بارهای کاری حساس را از یکدیگر و از منطقه غیرنظامی (DMZ) ایزوله میکند، طوری که نفوذ به یک بخش، بهخودیخود راهی به بخشهای دیگر باز نمیکند.
-
کنترل دسترسی مبتنی بر نقش و حداقل اختیارات: هر سرویس یا کاربر، فقط به منابعی دسترسی دارد که برای انجام وظیفهاش لازم است، نه بیشتر.
-
احراز هویت چندعاملی: برای تمام دسترسیهای مدیریتی و ورود از راه دور به سرورها الزامی است، نه یک گزینه اختیاری.
در عمل، ترافیک ورودی ابتدا از دیوار آتش برنامهمحور (WAF) و فایروال نسل جدید (NGFW) عبور میکند، سپس هویت کاربر یا سرویس تایید میشود، و تنها پس از آن اجازه ورود به منطقهی مربوطه (DMZ، ناحیه برنامه، یا ناحیه پایگاه داده) صادر میشود. وبسرورها و سرویسهای DNS نیز باید در همان ناحیه واسط مستقل باقی بمانند، دور از دسترسی مستقیم به منابع حساس داخلی.
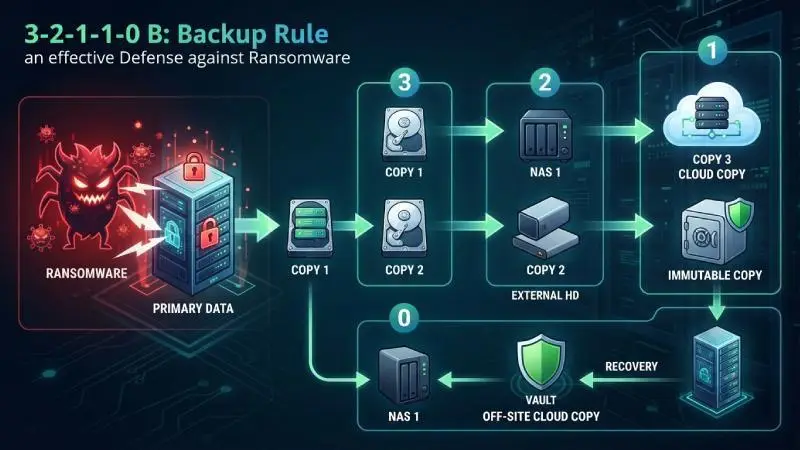
بکاپگیری در برابر باجافزار: قانون ۳–۲–۱–۱–۰
باجافزارهای پیشرفته امروز، دیگر فقط فایلها را رمزگذاری نمیکنند؛ اولین هدفشان، خود سرویسهای پشتیبانگیری و نسخههای سایه است. منطق مهاجم ساده است: اگر بکاپ نابود شود، مسیر بازگشت بدون مذاکره با مهاجم عملاً بسته میشود. به همین دلیل، پیش از هر چیز باید روشن کنیم بکاپ چیست؟ در معماری امروزی یک کپی ساده روی فایلسرور متصل به شبکه نیست؛ فرآیندی خودکار، رمزنگاریشده، ایزوله و غیرقابلتغییر است.
برای مقاومت واقعی در برابر این تهدید، قانون ۳–۲–۱–۱–۰ راهنمای عملی است: سه نسخه از داده، روی دو نوع رسانه متفاوت، یک نسخه خارج از محل اصلی، یک نسخه غیرقابلتغییر یا ایزوله فیزیکی، و صفر خطا در فرآیند بازیابی. رکن ضروری این قانون، استراتژی پشتیبانگیری با شکاف هوایی است. یعنی قطع کامل یا کنترلشدهی ارتباط بین نسخه پشتیبان و شبکه اصلی.
سه رویکرد رایج برای پیادهسازی این ایزولهسازی وجود دارد:
-
شکاف هوایی فیزیکی: قطع کامل اتصال، مثلاً نوار LTO. بالاترین سطح امنیت را دارد، اما بازیابی داده کند است.
-
شکاف هوایی منطقی: جداسازی شبکه با VLAN اختصاصی یکطرفه. قابلیت اتوماسیون بالایی دارد و برای سازمانهای بزرگ مناسبتر است، اما به دقت پیکربندی فایروال و مدیریت هویت وابسته است.
-
مخزن ابری با قفل منطقی: حساب کلود مجزا با قابلیت Object Lock در حالت Compliance، که حذف داده را حتی برای مدیر ارشد سیستم غیرممکن میکند.
یک نکته عملیاتی که اغلب نادیده گرفته میشود: پیش از انتقال هر داده به مخزن ایزوله، باید یک اسکن بدافزار پیش از انتقال (Pre-gap Scanning) انجام شود، وگرنه ممکن است خود بکاپ، ناقل آلودگی به نسخههای سالم قبلی شود. در کنار این، شاخصهای RTO (حداکثر زمان مجاز قطعی) و RPO (حداکثر دادهی قابل از دست رفتن) باید بهصورت دورهای، نه فقط روی کاغذ، بلکه با سناریوی واقعی بازیابی آزمایشی سنجیده شوند.
از مانیتورینگ واکنشگرا به هوش مصنوعی عملیاتی
مانیتورینگ سنتی، بر پایهی آستانههای ثابت کار میکند: وقتی مصرف CPU از ۹۰ درصد رد شد، هشدار بده. مشکل این مدل، هم دیر بودنش است و هم حجم بالای هشدارهای کاذب که تیم را نسبت به هشدارهای واقعی بیحس میکند. تا وقتی هشدار صادر میشود، حادثه معمولاً از مرحله پیشگیری عبور کرده است.
هوش مصنوعی در عملیات فناوری اطلاعات (AIOps) این مدل را از حالت واکنشی به پیشبینانه تغییر میدهد. الگوریتمهای یادگیری ماشین، رفتار نرمال شبکه و سرورها را یاد میگیرند و بهجای آستانهی ثابت، هر انحراف از الگوی معمول را (حتی قبل از رسیدن به بحران) شناسایی میکنند. این تفاوت کلیدی است: آستانهی ثابت میگوید «الان مشکل داری»، تشخیص ناهنجاری میگوید «رفتارت دارد از حالت عادی خارج میشود».
نتیجهی عملی این رویکرد، شبکهی خودترمیمشونده است: وقتی افت عملکرد تشخیص داده شود، سیستم میتواند بدون دخالت مستقیم اپراتور، ترافیک را به مسیر دیگری هدایت کند یا منابع تازه تخصیص دهد. این یعنی بخشی از زمان واکنش، از فرآیند انسانی حذف میشود.
ارزش این رویکرد در سه شاخص قابلاندازهگیری خلاصه میشود:
-
میانگین زمان بازیابی (MTTR): کاهش فاصلهی زمانی بین بروز مشکل و تشخیص علت ریشهای
-
نرخ پایبندی به SLA: میزان انطباق واقعی سرویسها با تعهدات سطح خدمات
-
درصد دسترسپذیری سیستم: پایداری واقعی کلسترهای پروداکشن در طول زمان
این سه شاخص، دقیقاً همانهایی هستند که در ابتدای مقاله به آنها اشاره کردیم؛ و نشان میدهند چطور امنیت کدپایه، معماری اعتماد صفر، بکاپ ایزوله و پایش هوشمند، در نهایت به یک نتیجهی واحد میرسند: کاهش ریسک عملیاتی قابلاندازهگیری.
چکلیست عملیاتی ۴ فازی برای ارزیابی آمادگی زیرساخت
برای اینکه این مقاله صرفاً یک بحث نظری نماند، جدول زیر همان الزامات را در قالب یک چکلیست قابلاجرا برای تیم دواپس و مدیران ارشد خلاصه میکند:
|
فاز |
اقدامات کلیدی |
|
۱. امنیت کدپایه |
یکپارچهسازی اسکنر SAST در CI/CD، استقرار OPA، انتقال کلیدها به Vault |
|
۲. شبکه و کنترل دسترسی |
ریزبخشبندی و جداسازی ناحیه واسط، الزام MFA و RBAC، پیکربندی WAF/NGFW |
|
۳. داده و بازیابی از فاجعه |
استقرار بکاپ با شکاف هوایی، فعالسازی قفل منطقی روی مخزن ابری، تست دورهای RTO/RPO |
|
۴. پایش و هوشمندسازی |
استقرار AIOps برای تشخیص ناهنجاری، خودکارسازی پاسخ به حادثه، رصد مستمر MTTR و SLA |
این چهار فاز، ترتیب اجرایی هم دارند: امنیت کدپایه و شبکه، سطح حمله را کوچک میکنند؛ بکاپ ایزوله، آخرین خط دفاع در برابر باجافزار را تضمین میکند؛ و پایش هوشمند، حلقهی بازخورد را میبندد تا مشکلات قبل از تبدیل شدن به حادثه، شناسایی شوند.
توسعه زیرساخت فناوری اطلاعات، پروژهای نیست که یکبار تمام شود و کنار گذاشته شود. هر تغییر در بار کاری، هر سرویس جدید، و هر الگوی تهدید تازه، این چهار فاز را دوباره به چالش میکشد. سازمانی که این چکلیست را به یک چرخهی مستمر تبدیل کند (نه یک ممیزی سالانه) همان سازمانی است که وقتی بحران واقعی از راه برسد، بهجای بازیابی اضطراری، فقط یک روند از پیش تمرینشده را اجرا میکند.
